Ciberseguridad Industrial Gestión de Riesgo OT 📅 Septiembre 2026 | ⏱️ 12 min de lectura
La mayoría de las instalaciones industriales en operación fueron diseñadas cuando el riesgo cibernético no existía como categoría. Rediseñar su arquitectura no es viable ni económica ni operacionalmente, y esa constatación produce parálisis: si no se puede hacer bien, no se hace nada. Los datos del SANS Institute muestran que la mitad de los incidentes industriales no se origina dentro de la planta, sino en cómo se entra a ella. Este análisis explica qué implica eso para las prioridades de inversión, y por qué buena parte de la reducción de riesgo disponible no requiere detener la producción.
Tres datos que reordenan las prioridades
SANS Institute, State of ICS/OT Cybersecurity 2025, sobre respuestas de 330 profesionales del sector industrial
50%
De los incidentes se originó en conectividad externa o rutas de acceso remoto
31%
De las organizaciones no mantiene inventario formal de sus puntos de acceso remoto
3%
De los incidentes tomó más de un año en resolverse hasta un estado operacional validado
El problema que conviene enunciar con precisión
Una planta construida en 1998 no tiene vulnerabilidades por descuido. Las tiene porque cuando se diseñó, la amenaza que hoy la afecta no existía como categoría.
Los controladores de esa época fueron construidos sobre una premisa razonable para su momento: operarían en redes cerradas, sin conexión externa, manipulados por personal presente físicamente. Bajo esa premisa, protocolos como Modbus no necesitaban autenticación. Nadie ajeno podía enviar una instrucción.
Esa premisa se rompió gradualmente, y casi siempre sin una decisión explícita. Se agregó un enlace para que el proveedor pudiera diagnosticar sin viajar. Se conectó el historiador al sistema de gestión para alimentar reportes. Se instaló un módem celular para telemetría de una estación remota. Se habilitó acceso durante la pandemia y nunca se revocó.
Ninguna de esas decisiones fue irresponsable. Cada una resolvía un problema operacional real. El resultado acumulado es una arquitectura que nadie diseñó y que nadie revisó como conjunto.
Por qué la respuesta habitual produce parálisis
Cuando una organización con este escenario consulta por ciberseguridad industrial, la respuesta frecuente plantea, explícita o implícitamente, una reconstrucción: segmentar la red de nuevo, reemplazar equipos que no soportan controles modernos, rediseñar la arquitectura conforme a un modelo de referencia.
Esa respuesta es técnicamente correcta y prácticamente inútil.
El costo es prohibitivo. Los tiempos de parada requeridos no existen en la planificación operacional. Los equipos que se propone reemplazar tienen años de vida útil restante.
El efecto no es que se ejecute una versión reducida del proyecto. El efecto es que no se hace nada, porque el marco mental instalado es que la seguridad industrial es un proyecto de reconstrucción, y ese proyecto no tiene presupuesto.
Dónde se originan realmente los incidentes
Los datos del SANS Institute permiten reemplazar la intuición por evidencia.
El 22% de las organizaciones experimentó un incidente de ciberseguridad industrial durante los doce meses cubiertos por la encuesta. De esos incidentes, el 38% involucró ransomware.
Pero el hallazgo que determina dónde conviene invertir es otro: la mitad de esos incidentes se originó en conectividad externa o rutas de acceso remoto.
No en el controlador sin parche. No en el protocolo sin autenticación. En cómo se entra a la planta.
Y en paralelo, la misma encuesta documenta el estado de los controles sobre ese vector.
| Control de acceso remoto | Lo implementan |
|---|---|
| Grabación y reproducción de sesión | 13% |
| Control consciente de dispositivo o protocolo industrial | 11% |
| Aprobación de sesión en tiempo real | 8% |
| Intermediación obligatoria por servidor de salto, alineada con la DMZ industrial del Modelo Purdue | 23% |
La conclusión operativa es directa: el vector que origina la mitad de los incidentes está severamente descontrolado en la mayoría de las organizaciones, y atenderlo no requiere tocar un solo controlador.
Por qué VPN y autenticación multifactor no cierran el problema
Existe una respuesta estándar cuando se plantea el tema del acceso remoto: ya tenemos VPN y autenticación de dos factores.
SANS aborda esa objeción directamente, y la formulación merece citarse porque resuelve la discusión.
VPN y autenticación multifactor confirman quién accede al entorno. No abordan qué acciones puede realizar esa persona, con qué dispositivos interactuará, ni cómo su actividad podría afectar las operaciones físicas.
En un entorno de oficina, saber quién entró suele ser suficiente. En una planta, donde un cambio de configuración puede tener consecuencias de seguridad física, quedan preguntas abiertas que la identidad no responde. A qué sistemas debería tener acceso esta persona. Qué actividad es apropiada. Si sus acciones son seguras para el proceso. Quién aprueba y supervisa su trabajo.
Ninguna de esas preguntas se contesta con credenciales válidas.
El costo real, medido en tiempo de recuperación
Para una conversación de presupuesto, la variable relevante no es la probabilidad del incidente. Es cuánto dura.
SANS documenta que las organizaciones mejoraron en detección: casi la mitad detecta incidentes dentro de 24 horas y más del 65% toma acción de contención al día siguiente.
La recuperación completa es otra historia.
| Tiempo hasta remediación completa | Organizaciones |
|---|---|
| Entre 2 y 7 días | 22% |
| Entre 1 y 3 meses | 8% |
| Más de un año | 3% |
Ese último dato merece detenerse. Tres de cada cien organizaciones que sufrieron un incidente industrial tardaron más de un año en volver a un estado operacional normal y validado.
La explicación que da SANS es la que un jefe de planta reconoce de inmediato: a diferencia de los activos de oficina, los dispositivos industriales no pueden simplemente reinstalarse o reemplazarse. Requieren actividades de reconstitución. Límites de alarma, modos de controlador de capa base, modos de control avanzado, secuencias de proceso y lógica de controlador deben revisarse y ajustarse para alinearse con las condiciones actuales del proceso.
Restaurar un servidor toma horas. Restaurar un proceso industrial toma lo que toma verificar que el proceso volvió a ser seguro.
Lo que la norma efectivamente permite
IEC 62443 fue escrita por personas que conocen esta realidad. Su modelo no asume instalaciones nuevas.
El mecanismo se denomina contramedida compensatoria, y su lógica es distinta a la que suele asumirse: el objetivo no es que cada dispositivo sea seguro, sino que el riesgo esté controlado.
Un controlador que no puede autenticar una instrucción sigue sin poder hacerlo. Pero si la única ruta hacia él pasa por un punto que sí autentica, verifica y registra, el riesgo se reduce sin haber intervenido el controlador.
Un dispositivo incapaz de defenderse a sí mismo puede ubicarse detrás de algo que lo defienda.
Lo que la norma exige a cambio es documentación. Identificar el requisito que el dispositivo no puede cumplir, especificar qué control lo compensa, y justificar por qué ese control cumple la misma función.
No es una excepción ni una concesión. Es el mecanismo previsto para instalaciones existentes.
Nota de precisión: el concepto de contramedida compensatoria está contenido en la serie IEC 62443. Las formulaciones divulgativas sobre su aplicación práctica provienen de documentación técnica del sector, no del texto normativo, cuya adquisición es necesaria para citarlo textualmente.
Dos ejes que conviene no confundir
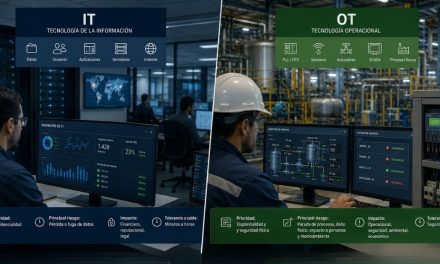
El Modelo Purdue organiza los activos industriales según su función y su distancia al proceso físico. Es el marco de referencia de la industria y responde una pregunta específica: dónde está este activo.
Existe una segunda pregunta que Purdue no responde y que determina la viabilidad de cualquier programa de seguridad: cuánto cuesta operacionalmente proteger este activo.
Ambos ejes son independientes, y confundirlos es lo que lleva a concluir que proteger los niveles cercanos al proceso exige detener la planta.
Un controlador ubicado en el Nivel 1 de Purdue puede protegerse monitoreando pasivamente su tráfico, sin tocarlo. O segmentando la ruta que llega hasta él, sin tocarlo. O reemplazándolo, lo que sí requiere parada. La ubicación del activo no determina el costo operacional de protegerlo.
Para ordenar un programa bajo restricción de continuidad operacional, propongo clasificar las intervenciones por su exigencia sobre la operación, no por dónde se aplican.
Categoría A — Sin interrupción operacional
Inventario de activos mediante escucha pasiva del tráfico. Inventario y control de rutas de acceso remoto. Monitoreo pasivo de red. Procedimiento de medios removibles. Documentación de la arquitectura real.
Ninguna requiere modificar un dispositivo de control ni detener producción. La segunda de la lista ataca el vector que origina la mitad de los incidentes.
Categoría B — Ventana de configuración de red
Segmentación entre el entorno de gestión y el operacional. Servidores intermedios de acceso controlado. Flujos unidireccionales para exportación de datos. Filtrado en el punto de conexión entre zonas.
Requieren trabajo de red y ventanas de configuración, no intervención de los sistemas de control.
Categoría C — Ventana de mantenimiento coordinada
Listas blancas de aplicaciones en estaciones de ingeniería. Pasarelas de protocolo que validan instrucciones. Protecciones perimetrales dedicadas a activos específicos.
Requieren coordinación con el fabricante y ventanas de mantenimiento, no reemplazo de equipo.
Categoría D — Parada de producción
Actualización de firmware. Reemplazo de controladores. Rediseño de arquitectura.
Es el nivel que domina las propuestas comerciales, y el único que exige lo que la organización no puede dar.
El punto central: el control que aborda el vector más frecuente pertenece a la Categoría A.
La pregunta que se puede responder esta semana
Existe un ejercicio de dos horas que entrega información accionable de inmediato, y que el 31% de las organizaciones nunca hizo.
¿Cuántas rutas de acceso remoto tiene esta instalación?
SANS documenta que el acceso remoto en entornos industriales es considerablemente más amplio de lo que se asume. La lista incluye portales de proveedores y fabricantes, paneles de mantenimiento basados en nube, herramientas de diagnóstico remoto, computadores portátiles de ingeniería, sesiones temporales de contratistas y módems celulares de campo.
Muchas de esas rutas se crearon por razones operacionales válidas, pero carecen de gobierno centralizado.
El dato que hace urgente el ejercicio: el 83% de las organizaciones depende de alguna capacidad conectada a la nube, ya sea por portales de soporte del fabricante, sistemas de mantenimiento predictivo, plataformas de analítica o historiadores corporativos. Y solo el 13% integró esa actividad a sus flujos de monitoreo.
Esto significa que una organización puede tener autenticación multifactor robusta en su VPN principal y simultáneamente mantener portales de proveedores, agentes embebidos o herramientas de automatización que ofrecen rutas de acceso que nadie inventarió.
SANS es explícito sobre la consecuencia: sin un inventario comprehensivo, los equipos de seguridad no pueden aplicar políticas consistentes ni asegurar que todas las rutas estén monitoreadas.
Dónde falla la detección
Un hallazgo adicional de la encuesta orienta dónde poner visibilidad primero.
Solo el 13% de las organizaciones reporta visibilidad completa a través de la cadena de ataque industrial. Y las brechas de detección más significativas aparecen en instalaciones remotas o no tripuladas.
La lógica es la que cabría esperar: esos sitios dependen fuertemente del acceso remoto por su distribución geográfica, y frecuentemente carecen de monitoreo suficiente. Dependencia máxima del vector más explotado, con la menor supervisión.
Para una organización chilena con estaciones de bombeo, subestaciones, plantas de tratamiento o instalaciones mineras distribuidas, ese hallazgo indica dónde empezar.
Indicadores de uso indebido que SANS enumera
- →Sesiones inesperadas fuera de horario
- →Accesos originados en la nube de forma inusual
- →Cambios súbitos de configuración en interfaces de operador o controladores
- →Actividad de firmware no autorizada
- →Acceso directo a dispositivos de campo
- →Anomalías en el historiador
- →Intentos irregulares de autenticación en estaciones de ingeniería
Cómo estructurar un programa que no dependa de completarse
El error de diseño más frecuente es plantear una secuencia donde el beneficio aparece al final. Si el proyecto se interrumpe, y los proyectos plurianuales frecuentemente se interrumpen, no queda nada.
La alternativa es estructurar fases donde cada una entregue reducción de riesgo medible por sí misma.
Fase 1
Saber qué hay
Inventario de activos por escucha pasiva y mapa de rutas de acceso externo. Es la única fase cuyo resultado es información en lugar de protección, y sin ella todo lo demás se decide a ciegas. Aborda directamente la brecha del 31%.
Fase 2
Cerrar el vector principal
Control, registro y revocación del acceso remoto de terceros. Es donde se origina la mitad de los incidentes y donde los controles avanzados no superan el 23% de adopción.
Fase 3
Separar los entornos
Segmentación en el punto de mayor acoplamiento entre el entorno de gestión y el operacional, con intermediación por servidor de salto alineada con la DMZ industrial.
Fase 4
Ver lo que pasa
Monitoreo pasivo, priorizando las instalaciones remotas donde la brecha de detección es mayor.
Fase 5
Poder volver
Respaldo verificado de configuraciones y lógica de control, fuera de la red operacional, con procedimiento de restauración probado. Los tiempos de recuperación documentados justifican esta inversión por sí solos.
Solo después tiene sentido discutir reemplazo de equipos. Y en ese momento la discusión será distinta: equipos específicos identificados por riesgo, no una reconstrucción general.
Qué implica en el contexto chileno
La Ley 21.663 exige a los Operadores de Importancia Vital implementar un sistema de gestión de ciberseguridad continuo y demostrar evidencia operativa de que sus controles funcionan.
Esa formulación admite lectura. No exige que los sistemas de control sean invulnerables. Exige que exista un programa, que el riesgo esté identificado y gestionado, y que haya evidencia de operación.
Un programa de controles compensatorios documentados satisface esa exigencia. Un proyecto de reconstrucción que nunca se ejecutó, no.
SANS aporta además un perfil de las organizaciones con mayor preparación, que sirve como referencia de destino: inventarios completos de acceso remoto, controles de acceso específicos del entorno industrial, monitoreo integrado entre ambos entornos, equipos de ingeniería involucrados, y ejercicios regulares que reflejan las realidades operacionales.
Ninguno de esos cinco elementos requiere reconstruir una planta.
Para entender la diferencia entre entornos de gestión y operacionales, revisa nuestra entrada sobre IT vs OT e IEC 62443. Para la evidencia histórica de ataques industriales, revisa la evolución de los ataques a redes OT. Y para el marco de gobernanza que sostiene un programa de este tipo, revisa gobernanza de seguridad en entornos IT y OT.
La brecha entre lo que la norma describe y lo que una instalación existente puede hacer es menor de lo que suele plantearse, pero requiere entender qué exige realmente la norma. No pide que cada dispositivo sea seguro. Pide que el riesgo esté identificado, controlado y documentado. Para una planta construida cuando el riesgo cibernético no existía, eso significa proteger las rutas en lugar de los destinos, empezar por donde se origina la mitad de los incidentes, y estructurar el programa de modo que cada fase valga por sí sola. El proyecto de reconstrucción que nunca comienza protege menos que el control compensatorio implementado el mes pasado.
Fuentes: SANS Institute, State of ICS/OT Cybersecurity 2025, basado en respuestas de 330 profesionales del sector industrial. Análisis de Michael Hoffman, Certified Instructor, publicado el 5 de enero de 2026 · IEC 62443, serie de normas internacionales para ciberseguridad de sistemas de automatización y control industrial · NIST Special Publication 800-82 Revisión 3, Guide to Operational Technology Security, septiembre de 2023 · Modelo Purdue de Arquitectura de Referencia Empresarial · Ley N.º 21.663, Marco de Ciberseguridad e Infraestructura Crítica de la Información, Chile.
¿Cuántas rutas de acceso remoto tiene realmente su instalación?
En CSITI realizamos el levantamiento de rutas de acceso externo y el inventario de activos OT mediante técnicas que no interfieren con la operación. El resultado es el mapa de la arquitectura real de su planta y un plan de intervención ordenado por costo operacional.